Текст и структура
Система читает скан или PDF и понимает, где какое поле.
Как это работает
- Документ приходит сканом, фото или файлом
- Модель распознаёт текст
- Поля раскладываются по структуре
Что получаете
Данные документа в виде полей, а не картинки.
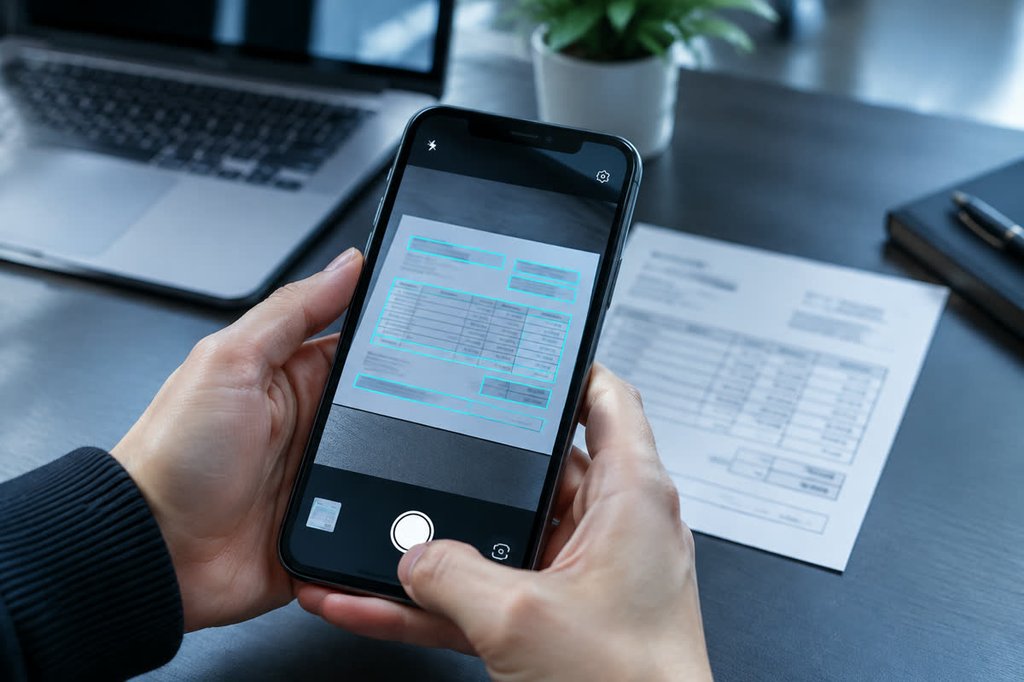
Счета, акты и накладные попадают в 1С без ручного ввода
Распознавание текста документов на нейросетях избавляет сотрудников от ручного ввода данных из счетов, актов, накладных, договоров и паспортов. Система читает скан или фото, понимает, какой это документ, извлекает нужные поля и переносит их в 1С, ERP или CRM. YAVVI разрабатывает такие решения под документы конкретной компании и разворачивает их на сервере заказчика, поэтому документы не покидают контур.
Система читает скан или PDF и понимает, где какое поле.
Как это работает
Что получаете
Данные документа в виде полей, а не картинки.
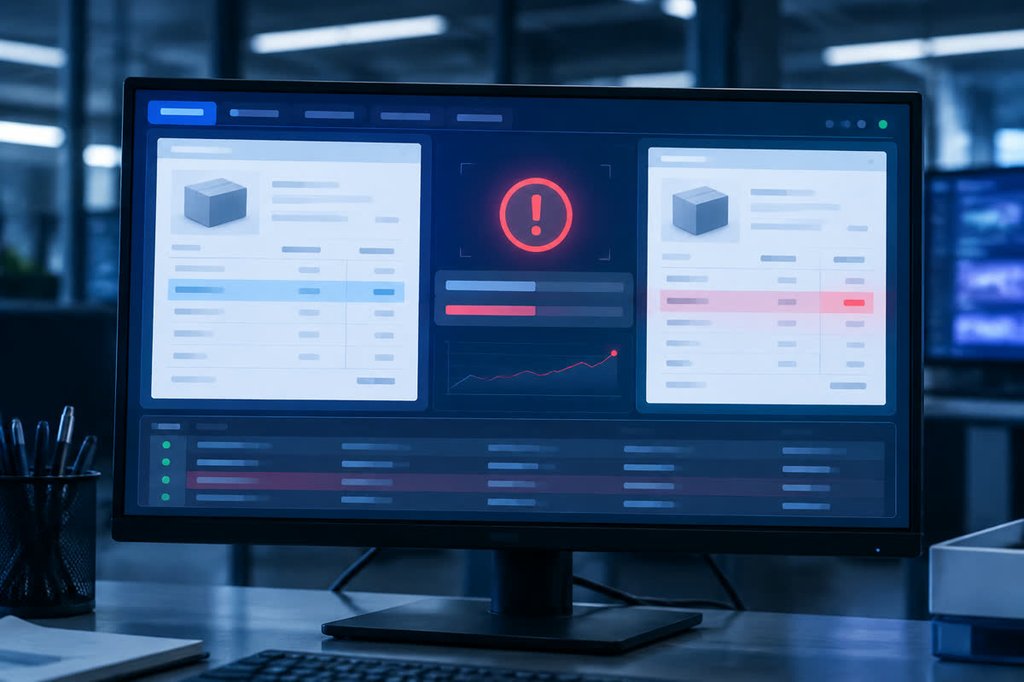
Сумма против договора, количество против заказа, реквизиты против карточки контрагента.
Как это работает
Что получаете
Ошибка в документе находится до проводки.
Модель дообучается на ваших типах документов.
Как это работает
Что получаете
Система понимает именно ваши формы.
Данные уходят в учётную систему, ЭДО или таблицу.
Как это работает
Что получаете
Документ оказывается в учёте без ручного ввода.
Скан превращается в текст с координатами слов
Нейросеть определяет тип документа и поля
Сомнительные поля помечаются для человека
Данные уходят в учётную систему
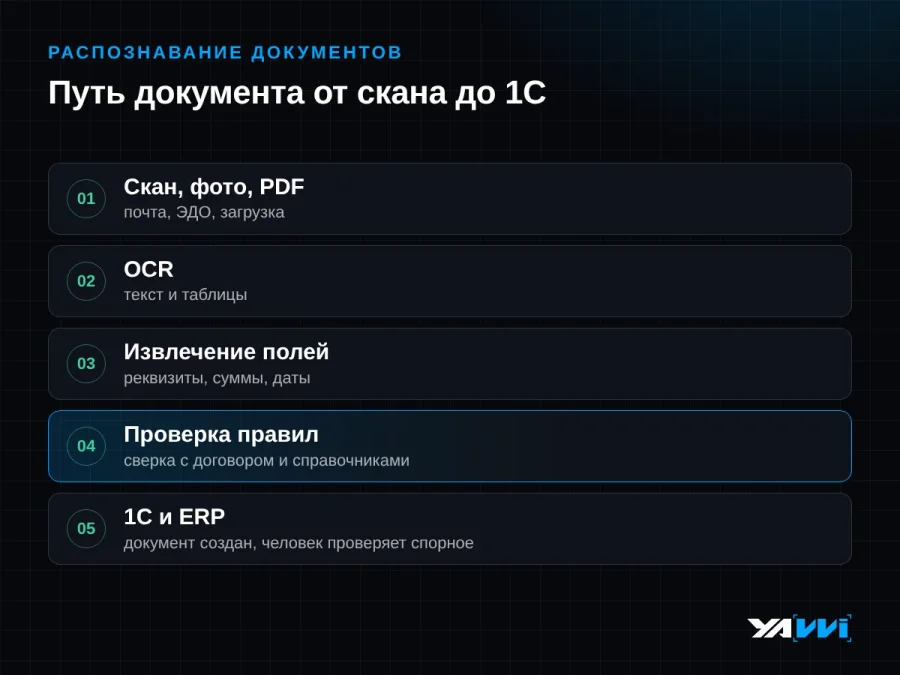
OCR документов в классическом виде переводит изображение в текст, но не понимает, где в нём номер счёта, а где сумма с НДС. Поэтому мы строим обработку в два слоя. Оптическое распознавание документа превращает скан в текст с координатами каждого слова, а нейросеть для обработки документов определяет тип документа и извлекает поля по смыслу, даже если у каждого поставщика своя форма счёта. Распознавание текста документов в два слоя даёт структурированные данные, которые сразу ложатся в поля учётной системы.
OCR-распознавание документов работает и с плохими сканами: перекошенными, с печатями поверх текста, сфотографированными на телефон. Перед распознаванием изображение выравнивается и очищается, а сомнительные поля система помечает для проверки человеком, поэтому ошибка не уходит в учёт молча.
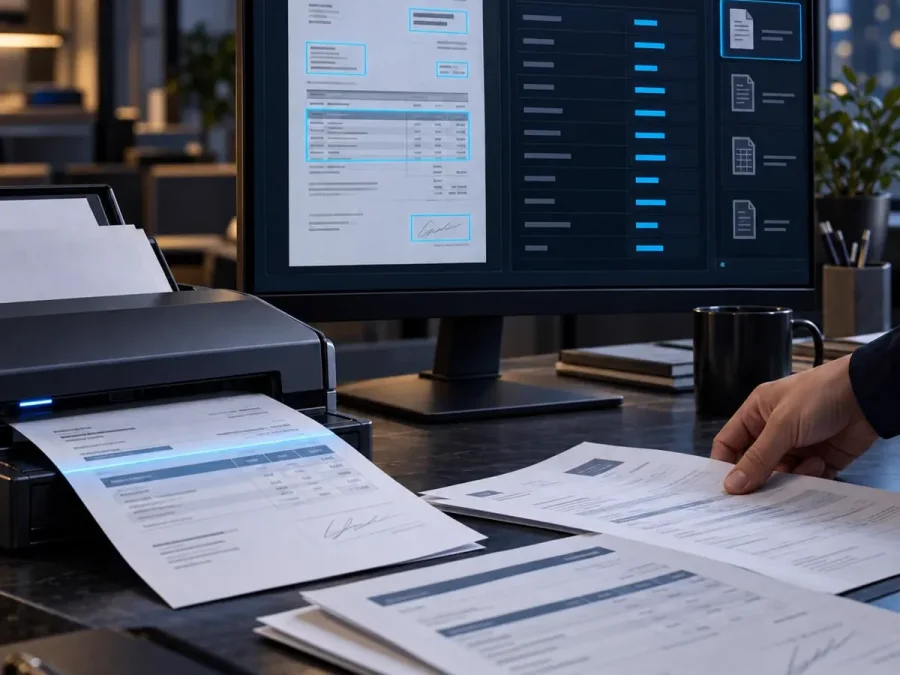
Автоматическое распознавание документов окупается там, где поток идёт сотнями в день: входящие счета в бухгалтерии, первичка на складе, анкеты клиентов, заявки на закупку. Сканирование, распознавание документа и проверка реквизитов идут одной цепочкой, поэтому сотрудник получает уже заполненную карточку и только подтверждает её.
ИИ для распознавания документов также сверяет данные между документами: сумму в счёте с договором, количество в накладной с заказом, реквизиты с карточкой контрагента. Расхождения система показывает до проведения документа, и ошибка находится до того, как попадёт в отчётность. Так системы распознавания документов становятся частью учётного процесса.
Распознавание электронного документа, например PDF без текстового слоя или письма с вложениями, идёт по тому же сценарию: система забирает файлы из почты или ЭДО, распознаёт и раскладывает их по нужным разделам учётной системы.
Счёт против договора
Накладная против заказа
Документ против карточки контрагента
Системы распознавания документов из коробки хорошо читают типовые формы, но спотыкаются на собственных бланках компании, таблицах со сложной вёрсткой и рукописных пометках. Мы дообучаем модель на ваших документах, поэтому точность растёт именно на тех формах, которые у вас встречаются. Оптическое распознавание документа после дообучения уверенно читает и таблицы, и штампы. Системы оптического распознавания документов у нас работают на открытых моделях и языковых моделях, установленных в контуре заказчика, без передачи документов внешним сервисам.
Обработка и распознавание документов в банках, страховании и медицине требуют защиты персональных данных, поэтому системы распознавания документов для этих отраслей разворачиваем только на сервере заказчика.
Модели работают в контуре заказчика, без внешних сервисов.
Как подключить распознавание документов без перестройки процессов: система встраивается в существующий поток, например в папку на сервере, почтовый ящик бухгалтерии или модуль 1С. Сначала собираем 100-200 примеров ваших документов и замеряем точность на них, затем настраиваем выгрузку в учётную систему и запускаем на части потока.
Разработка систем распознавания и обработки документов OCR под один тип документа занимает от трёх до шести недель. Оптическое распознавание документа OCR для нескольких десятков форм с интеграцией в учёт требует двух-трёх месяцев. Пришлите несколько типичных документов, и мы покажем, как распознавание текста документов сработает на них, до старта проекта.
 БэкофисИнтеграция ИИ в обработку документовКлассификация и маршрутизация входящих документов вместо ручного разбора Смотреть кейс
 AILegal Assistant - юридический AI-помощникTelegram Mini App: AI-ассистент для консультаций с юристами, генерация документов по шаблонам, напоминания о заседаниях. RAG-архитектура. Смотреть кейс
 AIAI-автоматизация медицинского порталаЧат-боты на NLP для первичного приёма пациентов, автоклассификация меддокументов, умная система рекомендаций контента. Смотреть кейс
Сканы и фотографии, PDF с текстовым слоем и без него, вложения из почты и ЭДО.
После дообучения на ваших документах модель уверенно читает таблицы и штампы, а сомнительные поля помечает для проверки человеком.
На сервере заказчика: модели работают в вашем контуре.
От трёх до шести недель для одного типа документа и два-три месяца для нескольких десятков форм с интеграцией в учёт.
Мой проект - тематический сайт знакомств. Я оцениваю его как проект высокого уровня сложности: очень непросто найти разработчиков, которые могли бы его реализовать. Я работал с командой Глеба в течение более двух лет с перерывами, которые были связаны исключительно с моим финансовым состоянием. По итогу могу сказать, что вполне доволен проделанной работой. Ребята знают своё дело, с хорошей коммуникабельностью, и всегда помогут советом. В данный момент вся основная работа сделана, сайт находится в рабочем состоянии и набирает пользователей. Есть идеи по добавлению новых функций, и если я решусь на это, то буду реализовывать их и дальше с этой командой.
Команда Глеба была профессиональной, оперативно реагировали на любые возникающие вопросы и шли навстречу в рабочих моментах. В ходе работы с командой были реализованы части и компоненты масштабного сервиса AI LMS платформы.
Мы разрабатывали несколько сервисов, часть из них запускалась в формате MVP: в частности, автоматизировали обработку запросов корпоративных заказчиков на аренду спортивных площадок. Команда проекта была на связи, и мы активно двигались по нашим требованиям. Достаточно оперативно реализовали и запустили продукт. Спасибо команде!
Обращались в YAVVI за доработками нашего сайта pakpakych.ru. Стек у нас не самый простой: Django, GarpixCMS и React SPA. До этого несколько подрядчиков ограничивались общими рекомендациями «в вакууме». Ребята зашли иначе: сначала провели полноценный технический аудит, разобрали каждый из 26 пунктов нашего ТЗ и по каждому написали, что уже реализовано, чего нет и почему. Отдельно ценно, что не стали продавать нам лишние работы, а честно указали, где функционал в проекте уже есть и где два пункта дублируют друг друга. По ходу аудита нашли критичную проблему, о которой мы не подозревали, и одна эта находка окупила всю работу. По каждой задаче была вилка часов и тип работ, никаких «примерно месяц», всё проверялось руками и подтверждалось инструментами. Каждая доработка выведена в админку, это принципиально: мы получили не разовый результат, а инструмент, плюс обучение нашей команды. Рекомендую тем, у кого нетиповой стек и нужен подрядчик, который сначала разберётся, а потом делает. Продолжаем сотрудничество.
Вам необязательно иметь чёткую задачу. Оставьте контакты, и мы разберём ваши текущие бизнес-процессы и честно покажем, где внедрение технологий даст реальный финансовый результат.
Связаться с нами