Интеграция ИИ в обработку документов
Классификация и маршрутизация входящих документов вместо ручного разбора
- Клиент
- Под NDA
- Сфера
- Документооборот и автоматизация бэкофиса
- Что делали
- ИИ и LLM
- Классификация документов
- Автоматизация процессов
Суть. Снять с сотрудников ручной разбор входящих документов: модель определяет тип каждого документа и отправляет его в нужный процесс.
Введение
Входящие документы разбирали вручную: сотрудник открывает файл, определяет его тип и решает, кому передать дальше. На большом потоке на это уходит время, которое нужно на работу с самими документами, а нестандартный документ легко теряется среди типовых.
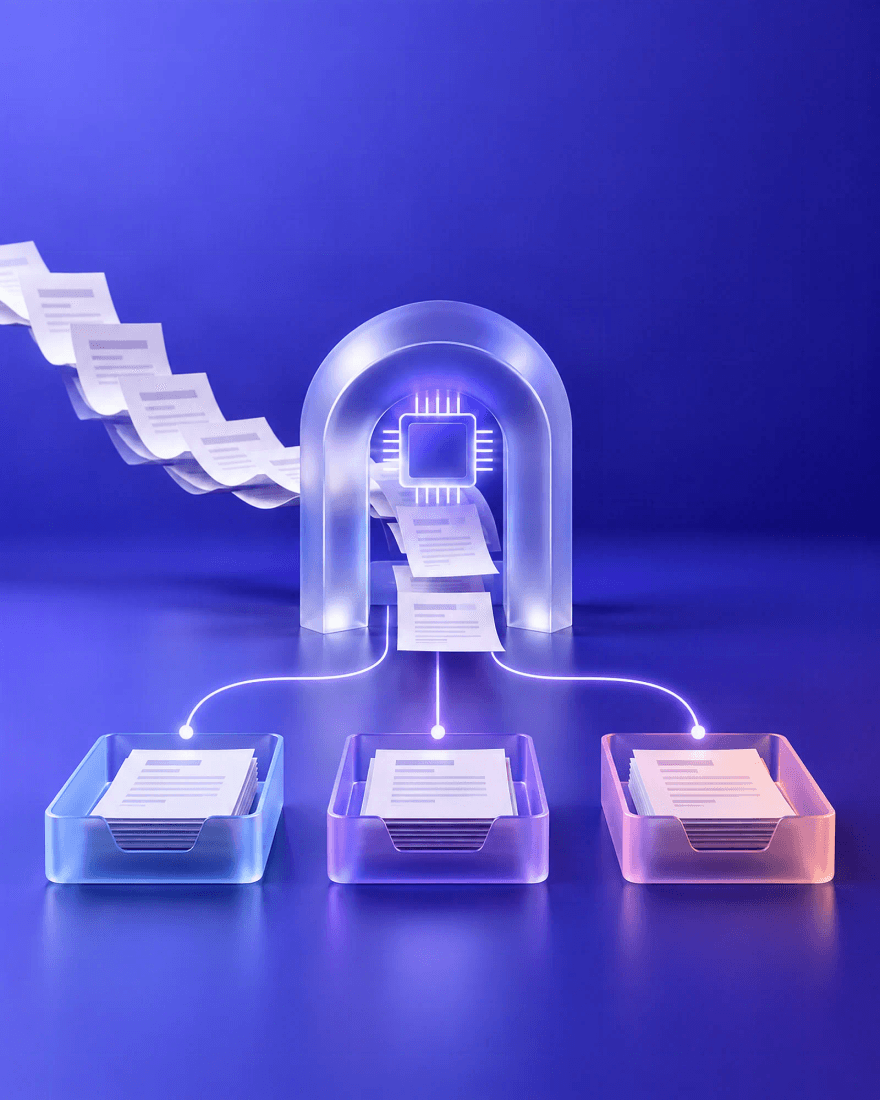
Мы встроили ИИ-модель, которая классифицирует входящие документы и маршрутизирует их. Документ приходит, получает категорию и уходит ответственному без ручной сортировки. Если модель не уверена, документ попадает к сотруднику, а его решение потом помогает дообучить классификатор.
Боль - запрос
Сотрудники тратят время на сортировку входящих документов.
Автоматическая классификация по типу документа.
Решение, кому передать документ, принимается вручную.
Маршрутизация в нужный процесс и к ответственному.
Документы приходят из разных каналов и в разном виде: письма, сканы, PDF.
Один входной поток с извлечением текста из любого формата.
Ошибка автоматической сортировки уводит документ не туда.
Порог уверенности и ручная проверка сомнительных случаев.
Нестандартные документы теряются в общем потоке.
Сотрудники занимаются исключениями, а не сортировкой.
Описание проекта
Поступление, классификация и передача документов собраны в один автоматический сценарий. Ручной шаг остался только там, где он нужен: на документах, в типе которых модель не уверена.
- Входной поток. Документы из почты и загрузки собираются в одну очередь, из сканов и PDF извлекается текст.
- ИИ-классификация. Модель определяет тип входящего документа и ставит оценку уверенности.
- Маршрутизация. По типу документа правила выбирают процесс и ответственного сотрудника или группу.
- Очередь исключений. Документы ниже порога уверенности и новые типы уходят сотруднику на разбор.
- Дообучение. Решения сотрудников по исключениям становятся размеченными примерами для следующей версии модели.
Архитектура решения
Как система выглядит в работе. Ниже - откуда она берёт данные, где их обрабатывает и куда отдаёт результат.
Входящая почта отдела
Письмо с вложением PDF, 3 страницы: «Направляем акт выполненных работ, просим подписать и вернуть один экземпляр».
Тип: акт выполненных работ, уверенность 0,96 при пороге 0,85. Документ направлен в процесс «Бухгалтерия: расчёты с поставщиками», ручная проверка не нужна.
- DOC-2026-073518
- Правила маршрутизации
- Извлечение текста3 страницы из вложения PDF
- Классификацияакт выполненных работ, уверенность 0,96
- Маршрут ответственномуБухгалтерия: расчёты с поставщиками
Документ с низкой уверенностью никогда не уходит в процесс автоматически: он ждёт решения сотрудника, и это решение потом учит модель.
Полная схема архитектуры и пример события
Источники
- Входящая почтаписьма с вложениями
- Сканы и PDFзагрузка сотрудниками
Что разработали мы
- Классификатор на LLMтип документа и уверенность
- Правила маршрутизациитип документа = процесс и ответственный
- Порог уверенностиниже порога - к сотруднику
Подключено:Извлечение текста
Кто и что получает
- Учётная система клиентадокумент в нужном процессе
- Очередь исключенийсотрудник разбирает сомнительное
- Набор для дообучениярешения по исключениям
Так это выглядит в работе
POST/docflow/api/documents/DOC-2026-073518/route
event- document.classified
document_id- DOC-2026-073518
sourcepages- 3
doc_type- акт выполненных работ
confidence- 96%
threshold- 0.85
needs_review- нет
routed_to- Бухгалтерия: расчёты с поставщиками
Как проходит документ
- Поступление. Документ приходит в систему из входящего потока, из скана или PDF извлекается текст.
- Классификация. Модель определяет тип документа и оценивает, насколько уверена в ответе.
- Маршрутизация. Документ с уверенным типом уходит в нужный процесс и к ответственному.
- Исключения. Сомнительные и нестандартные документы разбирает сотрудник, его решение сохраняется для дообучения.
Что было сложным
Эффект автоматической сортировки целиком зависит от точности на документах конкретного клиента. Типы документов похожи друг на друга: счёт и счёт-фактура, договор и дополнительное соглашение. Поэтому классификатор настраивали на реальном потоке клиента, а точность меряли по каждому типу отдельно, а не одной средней цифрой.
Ошибка маршрутизации хуже, чем отсутствие автоматизации: документ, ушедший не тому сотруднику, ищут дольше, чем если бы его разобрали руками. Поэтому порог уверенности выбран консервативно. Лучше отправить человеку лишний документ на проверку, чем потерять его в чужой очереди.
Результат проекта
- Быстрее. -40% времени на обработку рутинных документов.
- Один сценарий. Классификация и передача идут в одном автоматическом процессе.
- Фокус на исключениях. Сотрудники работают с нестандартными документами, а не с сортировкой.
- Модель учится на потоке. Решения по исключениям становятся данными для дообучения.
Проект в цифрах
- Длительность
- Около 3 месяцев: разметка потока клиента, пилот с ручной проверкой, затем автоматическая маршрутизация
- Команда
- 1 project manager
- 1 ML-инженер (LLM)
- 1 back-end разработчик
- 1 бизнес-аналитик
- -40%времени на обработку рутинных документов
- 1 сценарийот поступления документа до ответственного
- Порогуверенности: сомнительное проверяет человек
Технологии и интеграции
- Классификация документов на LLM
- Распознавание сканов и PDF
- Правила маршрутизации
- Порог уверенности и очередь исключений
- Интеграция с учётной системой по API
- Дообучение на решениях сотрудников
Частые вопросы
Сколько документов нужно, чтобы начать?
Обычно хватает нескольких десятков примеров на каждый тип из вашего реального потока. Их размечаем вместе с вашими сотрудниками на старте.
Что если модель ошибётся с типом?
Документ с низкой уверенностью не уходит в процесс автоматически, его проверяет сотрудник. Его решение попадает в дообучение, и такие ошибки со временем становятся реже.
Можно ли извлекать из документов данные, а не только тип?
Да, следующий шаг после классификации - извлечение реквизитов и сумм с проверкой по учётной системе. Это делается на той же схеме с порогом уверенности.
Как понять, что автоматизация окупается?
Меряем точность по каждому типу, долю документов без ручного вмешательства и время от поступления до исполнителя. Эти показатели видны уже на пилоте.
Проект под NDA: в публичном тексте только то, что согласовал клиент. Детали внедрения расскажем в переписке.